 lakaai
 Kiến thức AI
AI local làm video: máy nào chạy được, dùng model gì, có đáng không?
AI local làm video là gì, cần card đồ hoạ bao nhiêu GB, nên dùng Wan 2.2, LTX-2.5 hay HunyuanVideo, ComfyUI hay…
Cập nhật lần cuối: 25/09/2026
Tóm tắt nhanh
Bài này không có prompt mẫu tự nghĩ ra. Mọi prompt dưới đây mình chép từ video thật đã làm cho kênh mẹ và bé và kênh sa bàn, kèm khung hình của chính clip đó.
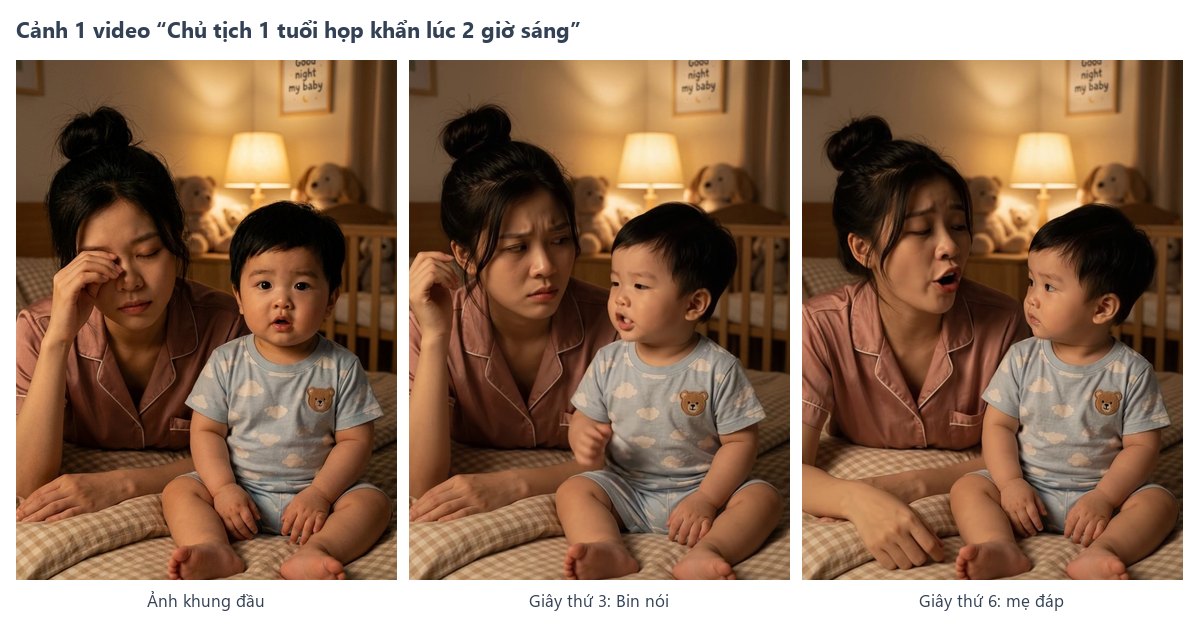
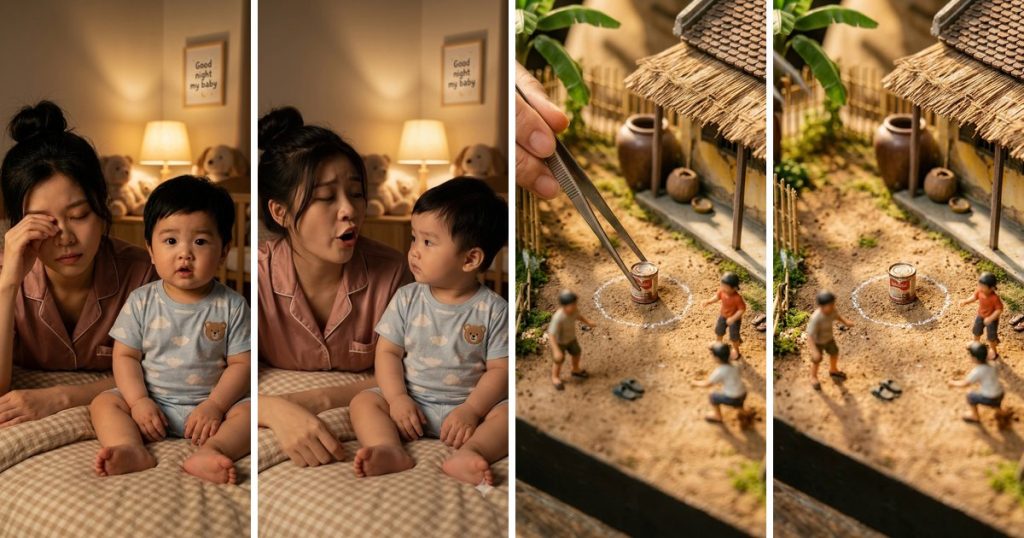
Clip trên làm bằng Omni 1.1 Flash, vì kênh mẹ và bé cần thoại. Video sa bàn ở cuối bài làm bằng Veo 3.1 Lite. Cách viết prompt giống nhau cho cả hai.
Mình luôn tạo ảnh trước, rồi dùng ảnh đó làm khung đầu cho video. Đây là prompt ảnh của cảnh ở trên, rút gọn phần mô tả nhân vật:
[TASK] Single photorealistic vertical 9:16 film frame for a Vietnamese mother-and-baby comedy sketch.
[CHARACTERS] Mẹ = the young mother: (đoạn mô tả cố định) | Bin = the 1-year-old baby boy: (đoạn mô tả cố định).
  Keep each person EXACTLY like their reference photo: same face, age, hair and outfit. Exactly 2 people, nobody else.
[SCENE] Vertical 9:16 frame, cozy dim bedroom at 2 AM with warm bedside lamp glow. Bin sitting upright on the beige checked duvet, looking super serious at camera. Mẹ sitting beside him on left, rubbing her eyes sleepily.
[STYLE] Real people, real skin texture, cinematic warm color grade, soft shallow depth of field, like a polished film still.
[BABY] The baby sits upright, face toward the camera, mouth clearly visible (never lying down, never from behind).
[MOUTHS] the 1-year-old baby boy (Bin) is about to speak (mouth slightly open); everyone else has their mouth CLOSED.
[AVOID] text, captions, watermark, logo, cartoon, 3D render, extra people, extra fingers, distorted baby anatomy.
Hai khối đáng chú ý nhất:
Đây là prompt video thật của cùng cảnh đó:
[SYSTEM] The attached image is the LITERAL FIRST FRAME; continue it as one continuous vertical 9:16 shot, same people, faces, outfits and room for the whole clip.
[ACTION] Bin sits tall and gestures with his small hand firmly. Mẹ yawns heavily and rubs her forehead in disbelief.
[DIALOGUE] The FIRST words of the clip are spoken by the 1-year-old baby boy (Bin), NOT by anyone else. Spoken word for word, in this exact order, natural real-time speed, all finished within 8 seconds:
  1) the 1-year-old baby boy (Bin) speaks in a cute high-pitched TODDLER voice: 'Mẹ ơi họp khẩn! Bỉm này làm mất dáng chủ tịch của em.' - only the baby's lips move, the young mother's mouth stays closed
  Then 2) the young mother (Mẹ) speaks in an adult young woman's voice: 'Hai giờ sáng rồi, đòi hỏi vừa thôi con!' - only the young mother's lips move, the baby's mouth stays closed.
[VOICE] the baby: cute, high-pitched toddler voice with a Northern Vietnamese accent | the young mother: warm, lively young Northern Vietnamese female voice. The baby's lines are ALWAYS in the toddler voice from the baby's own mouth; the mother never says the baby's lines.
[LIP_SYNC] Only the person saying a line moves their lips, only while saying it; the other listens and reacts.
[AUDIO] Only these voices plus soft room ambience, no music.
[AVOID] subtitles, on-screen text, other voices, slow motion, morphing faces, extra people appearing, the baby looking older.
Mỗi khối làm một việc:
Ngày 18/09, một clip có câu đầu là của Bin, nhưng người nói lại là mẹ. Nhìn lại ảnh khung đầu thì thấy mẹ đang há miệng, nên model cho mẹ nói trước.
Cách sửa là 3 chỗ cùng lúc: thêm [MOUTHS] vào prompt ảnh để chỉ bé hé miệng, thêm câu “The FIRST words of the clip are spoken by…”, và ghi sau mỗi câu thoại “only … lips move”. Mình ghi luôn vị trí người nói (bên trái, bên phải) khi trong cảnh có 2 người.
Cảnh bé nằm trên giường hoặc quay lưng thường ra clip không có câu thoại của bé. Từ đó mình đặt quy tắc: cảnh nào bé nói thì bé ngồi thẳng, mặt hướng về máy quay.
Đây là quy tắc mình đặt từ đầu chứ chưa phải lỗi: clip chỉ 8 giây, nên mình giới hạn 2–3 câu mỗi cảnh, mỗi câu 4–12 từ, tổng không quá khoảng 22 từ, và ghi rõ trong prompt là phải nói xong trong 8 giây. Mỗi câu cũng viết đủ chủ ngữ, xưng hô rõ ràng (“Mẹ ơi, con thấy…”) cho dễ hiểu.
Kênh sa bàn thu nhỏ không có lời nói, chỉ có tiếng động nhẹ. Prompt video ngắn hơn nhiều, và phần quan trọng là giữ cho mô hình không “sống dậy”:
[SYSTEM] The attached image is the LITERAL FIRST FRAME; continue it as one continuous vertical 9:16 shot.
[ACTION] The tweezers carefully lower and place the tiny milk tin upright inside the chalk circle on the soil, release it, and the hand smoothly retracts out of frame.
[CAMERA] slow gentle push-in, very steady. Everything stays a real handmade miniature: figurines do not come alive, only tiny natural motion (water ripples, leaves swaying, smoke curling).
[AUDIO] Only soft ASMR sounds: tweezers clicking, soft rustle, birdsong, water - no speech, no voice, no music.
[AVOID] talking, text, subtitles, morphing, extra hands, the diorama changing layout.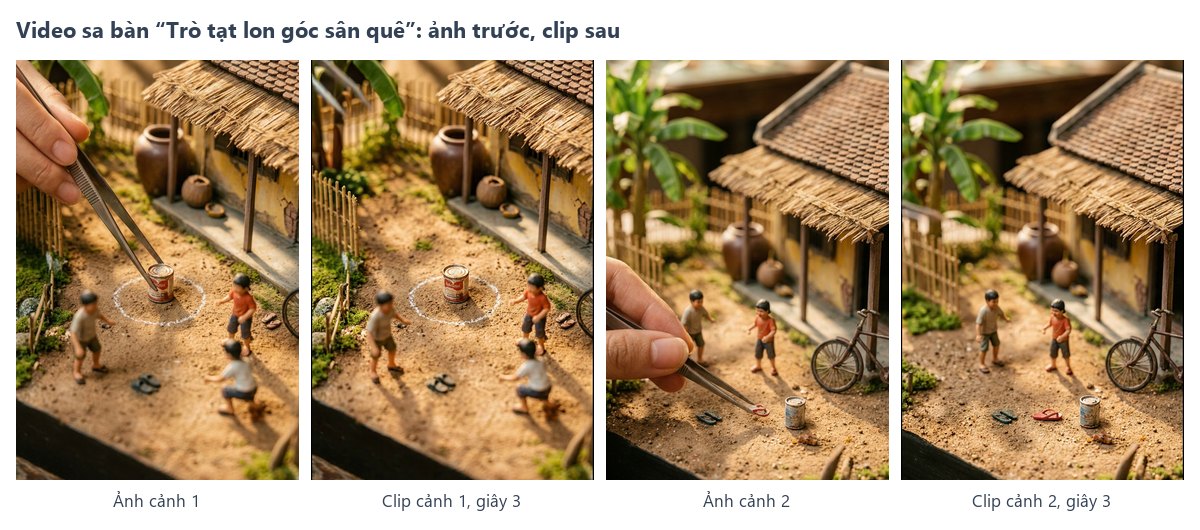
Câu “figurines do not come alive” để các hình nhân tí hon đứng yên như mô hình thật. Chỉ nước, lá và khói được chuyển động nhẹ, nên clip vẫn giữ cảm giác đang quay một sa bàn.
Thay phần trong ngoặc đơn bằng nội dung của bạn:
[SYSTEM] The attached image is the LITERAL FIRST FRAME; continue it as one continuous vertical 9:16 shot, same people, faces, outfits and place for the whole clip.
[ACTION] (1 hành động chính, nhìn thấy được)
[DIALOGUE] The FIRST words are spoken by (người A, vị trí trái/phải). Spoken word for word, in this exact order, all finished within 8 seconds:
  1) (người A) speaks: '(câu tiếng Việt)' - only (người A)'s lips move
  Then 2) (người B) speaks: '(câu tiếng Việt)' - only (người B)'s lips move
[VOICE] (người A): (giọng, tuổi, vùng miền) | (người B): (giọng, tuổi, vùng miền)
[LIP_SYNC] Only the person saying a line moves their lips; the other listens and reacts.
[AUDIO] Only these voices plus soft room ambience, no music.
[AVOID] subtitles, on-screen text, other voices, morphing faces, extra people appearing.
Nếu không muốn tự viết từng cảnh, phần mềm làm video của mình tự dựng prompt theo khung này cho mọi cảnh. Còn nếu nhân vật của bạn hay bị đổi mặt giữa các cảnh, xem thêm bài cách giữ nhân vật AI không đổi mặt.
Được, nhưng mình viết phần mô tả bằng tiếng Anh và chỉ để lời thoại bằng tiếng Việt. Cách này giúp tách bạch phần “tả cảnh” với phần “nói nguyên văn”, và mình dễ kiểm tra hơn.
Ghi thẳng vào khối [VOICE], ví dụ “Northern Vietnamese accent” hoặc “Southern Vietnamese accent”, kèm tuổi và tính cách giọng nói.
Mình để 2–3 câu ngắn, tổng khoảng 22 từ trở xuống, để nhân vật nói ở tốc độ bình thường mà vẫn kịp trong 8 giây.
Kiến thức AI
AI local làm video là gì, cần card đồ hoạ bao nhiêu GB, nên dùng Wan 2.2, LTX-2.5 hay HunyuanVideo, ComfyUI hay…
 Kiến thức AI
So sánh các model tạo video AI mới nhất 2026: chức năng, loại video phù hợp và giá thật của Google Flow…
 Kiến thức AI
Nhân vật AI tự tạo mà Flow vẫn báo vi phạm chính sách người nổi tiếng? Vì sao bị nhận nhầm và…
Có bản miễn phí để dùng thử, tải về cài là chạy.